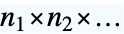


ParallelArray
ParallelArray[f,n]
長さ n で要素 f[i]が評価されたリストを並列で生成する.
ParallelArray[f,{n1,n2,…}]
要素f[i1,i2,…]を持つネストしたリストの 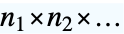 配列を並列に生成する.
ParallelArray[f,{n1,n2,…},{r1,r2,…}]
指標の基点(デフォルトは1)として ri を使ってリストを並列に生成する.
ParallelArray[f,dims,origin,h]
配列の各レベルの頭部にはListではなく h を使う.
詳細とオプション
- ParallelArrayはArrayの並列版で,expr の異なる評価を異なるカーネルとプロセッサ間に自動的に分配する.
- ParallelArrayは,計算途中の副産物を除き,Arrayと同じ結果を与える.
- Parallelize[Array[f,n]]はParallelArray[f,n]に等しい.
- ParallelArrayのインスタンスが並列化できない場合,そのインスタンスはArrayを使って評価される.
- 次は,使用可能なオプションである.
-
Method Automatic 並列化の粒度 DistributedContexts $DistributedContexts 並列計算にシンボルを分配するために使われるコンテキスト ProgressReporting $ProgressReporting 計算の進捗報告を行うかどうか - Methodオプションは使用する並列化の方法を指定する.次は,その可能な設定である.
-
"CoarsestGrained" 計算を使用可能なカーネル数まで分割する "FinestGrained" 計算を可能な最小サブユニットまで分割する "EvaluationsPerKernel"->e 計算をカーネルごとに最高で e 個まで分割する "ItemsPerEvaluation"->m 計算をそれぞれ最大 m 個のサブユニットの評価に分割する Automatic オーバーヘッドと負荷分散の間で妥協する - Method->"CoarsestGrained"は多くのサブユニットを含みそれぞれの時間量が等しい計算に適している.オーバーヘッドは最小になるが負荷分散は提供しない.
- Method->"FinestGrained"はサブユニット数が少ないがそれぞれの時間が異なる計算に適している.オーバーヘッドは高くなるが負荷分散が最大になる.
- DistributedContextsオプションは expr 中のどのシンボルの定義を計算前に自動的に使用可能な全カーネルに配布するかを指定する.
- デフォルト値はDistributedContexts:>$DistributedContextsで$DistributedContexts:=$Contextであり,現行コンテキスト内の全シンボルの定義が配布されるが,パッケージからのシンボルの定義は配布されない.
- ProgressReportingオプションは並列計算の進捗報告をするかどうかを指定する.
- デフォルト値はProgressReporting:>$ProgressReportingである.
例題
すべて開く すべて閉じる例 (4)
ParallelArrayは並列である点は別にしてArrayのように働く:
Array[(Pause[1];f[#])&, 4]//AbsoluteTimingParallelArray[(Pause[1];f[#])&, 4]//AbsoluteTiming
ParallelArray[f, {3, 2}]
ParallelArray[10#1 + #2&, {3, 4}]ParallelArray[f, 10, 0]ParallelArray[f, {2, 3}, {0, 4}]結果の式に,Listの代りに h を使う:
ParallelArray[f, {3, 2}, 1, h]オプション (13)
Method (6)
ParallelArray[Labeled[Framed[#], $KernelID]&, 10, Method -> "FinestGrained"]ParallelArray[Labeled[Framed[#], $KernelID]&, 10, Method -> "CoarsestGrained"]1つのカーネルにつき最大で2つの評価になるようにジョブ全体の計算を分割する:
ParallelArray[Labeled[Framed[#], $KernelID]&, 12, Method -> "EvaluationsPerKernel" -> 2]ParallelArray[Labeled[Framed[#], $KernelID]&, 18, Method -> "ItemsPerEvaluation" -> 5]デフォルトのオプション設定では評価のサイズと評価数のバランスが取られる:
ParallelArray[Labeled[Framed[#], $KernelID]&, 18, Method -> Automatic]ランタイムが大きく異なる計算はできるだけきめ細かく並列化しなければならない:
ParallelArray[PrimeQ[2 ^ # - 1]&, 20, 4410, Method -> "FinestGrained"]多数の簡単な計算は可能な限り少ないまとまりとして分配されるべきである:
BinCounts[ParallelArray[Mod[Floor[# * Pi], 10]&, 10000, 1, Method -> "CoarsestGrained"], {0, 10}]DistributedContexts (5)
remote[x_] := Labeled[Framed[x], $KernelID]ParallelArray[remote, 4]local[x_] := Labeled[Framed[x], $KernelID]ParallelArray[local, 4, DistributedContexts -> None]並列計算のすべてのコンテキストのすべての記号の定義を配布する:
a`f[x_] := Labeled[Framed[x], $KernelID]ParallelArray[a`f, 4, DistributedContexts -> Automatic]b`g[x_] := Labeled[Framed[x], $KernelID]ParallelArray[b`f, 4, DistributedContexts -> {"a`"}]DistributedContextsオプションの値をデフォルトに戻す:
SetOptions[ParallelArray, DistributedContexts :> $DistributedContexts]ProgressReporting (2)
res = ParallelArray[PrimeQ[2 ^ # - 1]&, 10000, ProgressReporting -> False];Method"FinestGrained"を使って最も正確な進捗情報を得る:
res = ParallelArray[PrimeQ[2 ^ # - 1]&, 10000,
	Method -> "FinestGrained", ProgressReporting -> True];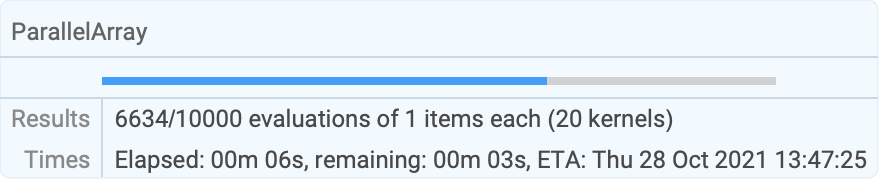
| |
考えられる問題 (2)
並列カーネルにとって未知の関数が使われると評価が連続的に行われることがある:
ftest[n_] := Labeled[Framed[PrimeQ[2 ^ n - 1]], $KernelID]ParallelArray[ftest, 10, DistributedContexts -> None]DistributeDefinitions[ftest]ParallelArray[ftest, 10, DistributedContexts -> None]gtest[n_] := Labeled[Framed[PrimeQ[2 ^ n - 1]], $KernelID]ParallelArray[gtest, 10]デフォルトコンテキスト以外のコンテキストからの定義は自動的には配布されない:
ctx`mtest[n_] := Labeled[Framed[PrimeQ[2 ^ n - 1]], $KernelID]ParallelArray[ctx`mtest, 10]DistributeDefinitionsを使ってそのような定義を配布する:
DistributeDefinitions[ctx`mtest];ParallelArray[ctx`mtest, 10]すべてのコンテキストが含まれるようにDistributedContextsを設定することもできる:
cty`mtest[n_] := Labeled[Framed[PrimeQ[2 ^ n - 1]], $KernelID]ParallelArray[cty`mtest, 10, DistributedContexts -> Automatic]テキスト
Wolfram Research (2008), ParallelArray, Wolfram言語関数, https://reference.wolfram.com/language/ref/ParallelArray.html (2021年に更新).
CMS
Wolfram Language. 2008. "ParallelArray." Wolfram Language & System Documentation Center. Wolfram Research. Last Modified 2021. https://reference.wolfram.com/language/ref/ParallelArray.html.
APA
Wolfram Language. (2008). ParallelArray. Wolfram Language & System Documentation Center. Retrieved from https://reference.wolfram.com/language/ref/ParallelArray.html