

TTest
詳細とオプション
- TTestは帰無仮説
 と対立仮説
 で検定を行う.
-


data 

{data1,data2} 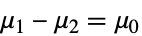
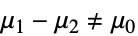
- ただし,μiは dataiの母平均である.
- デフォルトで,確率値つまり
 値が返される.
- 小さい
 値は
 が真である可能性が低いことを示す.
- dspec 中のデータは一変量{x1,x2,…}でも多変量{{x1,y1,…},{x2,y2,…},…}でもよい.
- 引数 μ0は実数あるいはデータの次元と長さが等しい実ベクトルでよい.
- TTestはデータが正規分布に従うと仮定するが,この仮定についてかなり強力である.TTestはまた2つのサンプルがある場合はサンプルがそれぞれ独立であると仮定する.
- TTest[dspec,μ0,"HypothesisTestData"]はHypothesisTestDataオブジェクト htd を返す.これは htd["property"]として追加的な検定結果と特性の抽出に使うことができる.
- TTest[dspec,μ0,"property"]を使って直接"property"の値を与えることができる.
- 検定結果のレポートに関連する特性
-
"DegreesOfFreedom" 検定で使用される自由度 "PValue"  値のリスト
"PValueTable"  値のフォーマットされた表
"ShortTestConclusion" 検定結果の簡単な説明 "TestConclusion" 検定結果の説明 "TestData" 検定統計と  値のペアのリスト
"TestDataTable" 検定統計と  値のフォーマットされた表
"TestStatistic" 検定統計のリスト "TestStatisticTable" 検定統計のフォーマットされた表 - 一変量のサンプルの場合,TTestはスチューデント
 検定を行う.検定統計はStudentTDistribution[df]に従うと仮定される.
- 多変量のサンプルの場合,TTestはHotellingの
 検定を行う.検定統計はHotellingTSquareDistribution[p,df]に従うと仮定される.ただし,p は data の次元である.
- 検定統計の分布指定に使われる自由度 df は,サンプルの大きさ,サンプル数,さらに2つの一変量サンプルの場合は分散が等しいかどうかの検定結果に依存する.
- 使用可能なオプション
-
AlternativeHypothesis "Unequal" 対立仮説のための不等式 SignificanceLevel 0.05 診断と報告のための切捨て VerifyTestAssumptions Automatic どの仮定を検証するか - TTestでは,
 のときにのみ
 が棄却されるような切捨て
 が選択される.特性"TestConclusion"および"ShortTestConclusion"で使われる
 の値はSignificanceLevelオプションで制御される.
 の値は,正規性,等分散,対称性の検定を含む仮定の診断検定にも使われる.デフォルトで
 は0.05に設定される.
- TTestにおけるVerifyTestAssumptionsの名前付き設定
-
"Normality" すべてのデータが正規分布に従うことを検証する "EqualVariance" data1と data2が等分散であることを検証する
例題
すべて開く すべて閉じる例 (3)
data = RandomVariate[NormalDistribution[0.05, 1], 10^4];TTest[data]TTest[data, Automatic, "TestDataTable"]
BlockRandom[SeedRandom[1];data1 = RandomVariate[NormalDistribution[1.85, 1], 1000];
	data2 = RandomVariate[NormalDistribution[0, 1], 1000]];
Mean[data1] - Mean[data2]SmoothHistogram[{data1, data2 + 2}]
TTest[{data1, data2}, 2]BlockRandom[SeedRandom[1];data1 = RandomVariate[MultinormalDistribution[{1, 2}, IdentityMatrix[2]], 1000];
data2 = RandomVariate[MultinormalDistribution[{0, 0}, IdentityMatrix[2]], 1000]];
Mean[data1] - Mean[data2]Histogram3D[{data1, Transpose[Transpose[data2] + {1, 2}]}]
TTest[{data1, data2}, {1, 2}]スコープ (13)
検定 (10)


SeedRandom[1];
data1 = RandomVariate[NormalDistribution[0, 1], 500];
data2 = RandomVariate[NormalDistribution[3, 1], 500];

TTest[data1]

TTest[data2]Automaticを使うことは,ゼロの平均について検定することと同じである:
data = RandomVariate[NormalDistribution[0, 1], 500];TTest[data, 0]TTest[data, Automatic]


SeedRandom[1];
data1 = RandomVariate[NormalDistribution[3, 1], 500];
data2 = RandomVariate[NormalDistribution[0, 1], 200];

TTest[data1, 3]

TTest[data2, 3]多変量データ集合の平均ベクトルがゼロベクトルであるかどうかを検定する:
SeedRandom[1];data = RandomVariate[MultinormalDistribution[{.1, 0, -.05, 0}, IdentityMatrix[4]], 10^3];TTest[data]TTest[data, {0.1, 0, -.05, 0}]
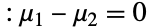

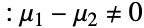
SeedRandom[1];data1 = RandomVariate[NormalDistribution[0, 1], 100];
data2 = RandomVariate[NormalDistribution[1, 1], 150];
data3 = RandomVariate[NormalDistribution[0, 2], 130];
TTest[{data1, data2}, 0]
TTest[{data1, data3}, 0]
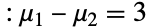

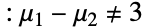
SeedRandom[1];data1 = RandomVariate[NormalDistribution[3, 1], 135];
data2 = RandomVariate[NormalDistribution[0, 1], 100];TTest[{data1, data2}, 3]TTest[{data2, data1}, 3]2つの多変量データ集合の平均差分ベクトルがゼロベクトルであるかどうかを検定する:
SeedRandom[1];data1 = RandomVariate[MultinormalDistribution[{.5, 0, -.5, 0}, IdentityMatrix[4]], 122];data2 = RandomVariate[MultinormalDistribution[{-.5, 0, .5, 0}, IdentityMatrix[4]], 135];TTest[{data1, data2}]TTest[{data1, data2}, {1, 0, -1, 0}]繰り返し特性を抽出するためにHypothesisTestDataオブジェクトを作成する:
SeedRandom[1];data = RandomVariate[NormalDistribution[], {2, 10^4}];ℋ = TTest[data, 0, "HypothesisTestData"];ℋ["Properties"]HypothesisTestDataオブジェクトから特性を抽出する:
SeedRandom[2];data = RandomVariate[NormalDistribution[], {2, 10^4}];ℋ = TTest[data, 0, "HypothesisTestData"];
ℋ["PValue"]ℋ["TestStatistic"]ℋ["DegreesOfFreedom"]SeedRandom[2];data = RandomVariate[NormalDistribution[], {2, 10^4}];ℋ = TTest[data, 0, "HypothesisTestData"];
ℋ["PValue", "TestStatistic", "DegreesOfFreedom"]レポート (3)
SeedRandom[1];data = RandomVariate[NormalDistribution[], {2, 20}];ℋ = TTest[data, 0, "HypothesisTestData"];ℋ["TestDataTable"]SeedRandom[1];data = RandomVariate[NormalDistribution[], {1000, 25}];res = Table[TTest[v, 0, "TestData", VerifyTestAssumptions -> None], {v, data}];ListPlot[res, FrameLabel -> {"T", "p-value"}, Frame -> True, PlotRange -> All]
SeedRandom[1];data = RandomVariate[NormalDistribution[], {2, 10^2}];ℋ = TTest[data, 0, "HypothesisTestData"];ℋ["PValueTable"]
ℋ["PValue"]ℋ["TestStatisticTable"]ℋ["TestStatistic"]オプション (11)
AlternativeHypothesis (3)
SeedRandom[1];
data = RandomVariate[NormalDistribution[], 100];


TTest[data, 0, AlternativeHypothesis -> "Unequal"]TTest[data, 0, AlternativeHypothesis -> Automatic]SeedRandom[1];
data = RandomVariate[NormalDistribution[], 100];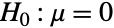
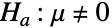
TTest[data, 0, AlternativeHypothesis -> "Unequal"]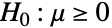
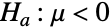
TTest[data, 0, AlternativeHypothesis -> "Less"]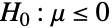
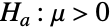
TTest[data, 0, AlternativeHypothesis -> "Greater"]
SeedRandom[1];
data1 = RandomVariate[NormalDistribution[2.9, 1], 1000];
data2 = RandomVariate[NormalDistribution[0, 1], 1000];Mean[data1] - Mean[data2]
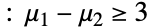

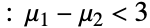
TTest[{data1, data2}, 3, AlternativeHypothesis -> "Less"]
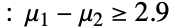

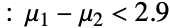
TTest[{data1, data2}, 2.9, AlternativeHypothesis -> "Less"]SignificanceLevel (2)
data = BlockRandom[SeedRandom[2];RandomVariate[StudentTDistribution[3], 50]];TTest[data, 0, SignificanceLevel -> .0001]TTest[data, 0]
有意水準は"TestConclusion"と"ShortTestConclusion"にも使われる:
BlockRandom[SeedRandom[1];data = RandomVariate[NormalDistribution[0, 1], 100]];Mean[data]ℋ1 = TTest[data, .2, "HypothesisTestData", SignificanceLevel -> .1];ℋ2 = TTest[data, .2, "HypothesisTestData", SignificanceLevel -> .005];ℋ1["TestConclusion"]//TraditionalFormℋ2["TestConclusion"]//TraditionalFormℋ1["ShortTestConclusion"]ℋ2["ShortTestConclusion"]VerifyTestAssumptions (6)
data1 = RandomVariate[NormalDistribution[0, 1], 100];
data2 = RandomVariate[NormalDistribution[0, 2], 100];TTest[{data1, data2}, 0, VerifyTestAssumptions -> Automatic]TTest[{data1, data2}, 0, VerifyTestAssumptions -> None]AllあるいはNoneを使ってまとめて診断を制御することができる:
data1 = RandomVariate[NormalDistribution[0, 1], 100];
data2 = RandomVariate[NormalDistribution[0, 2], 100];TTest[{data1, data2}, 0, VerifyTestAssumptions -> All]TTest[{data1, data2}, 0, VerifyTestAssumptions -> None]data1 = RandomVariate[NormalDistribution[0, 1], 100];
data2 = RandomVariate[NormalDistribution[0, 2], 100];TTest[{data1, data2}, 0, VerifyTestAssumptions -> "EqualVariance"]TTest[{data1, data2}, 0, VerifyTestAssumptions -> "Normality"]等分散の仮定をFalseに設定する:
TTest[{data1, data2}, 0, VerifyTestAssumptions -> "EqualVariance" -> False]data = RandomVariate[CauchyDistribution[0, 1], 100];TTest[data, 0, VerifyTestAssumptions -> "EqualVariance"]TTest[data, 0, VerifyTestAssumptions -> All]
data = RandomVariate[MultinormalDistribution[{0, 0, 0}, IdentityMatrix[3]], 10 ^ 4];TTest[data, Automatic, "TestDataTable", VerifyTestAssumptions -> All]//AbsoluteTimingTTest[data, Automatic, "TestDataTable", VerifyTestAssumptions -> None]//AbsoluteTimingシミュレーションを行う場合は,診断検定を行わないようにすると有益であることが多い:
data = RandomVariate[NormalDistribution[], {1000, 100}];AbsoluteTiming[T = Quiet@TTest[#, Automatic, "TestStatistic"]& /@ data;]検定の仮定は意図的に有効になっているので,時間が大幅に短縮できる:
AbsoluteTiming[T2 = Quiet@TTest[#, Automatic, "TestStatistic", VerifyTestAssumptions -> None]& /@ data;]SmoothHistogram[{T, T2}]アプリケーション (4)
SeedRandom[1];data1 = RandomVariate[NormalDistribution[0, 1], 100];
data2 = RandomVariate[NormalDistribution[0, 1], 100];
data3 = RandomVariate[NormalDistribution[2, 1], 100];BoxWhiskerChart[{data1, data2, data3}]TTest[{data1, data2}, Automatic, "TestDataTable"]TTest[{data1, data3}, Automatic, "TestDataTable"]光の通過速度の3つ目の一連の測定値は,1882年にニューコム(Newcomb)よって記録された.与えられた値を1000で割って24加えたものは,既知の距離を光が移動する時間(単位:100万分の1秒)を与える.現在のところ,真の値は33.02であると考えられている:
lspeed = ExampleData[{"Statistics", "NewcombLightSpeed"}];SmoothHistogram[lspeed, PlotRange -> All]ショーブネ(Chauvenet)の基準を使って外れ値を識別する:
ChauvenetOutlier[d_, data_] := Probability[x <= d, xNormalDistribution[Mean[data], StandardDeviation[data]]] < (1/2Length[data])outliers = Select[lspeed, ChauvenetOutlier[#, lspeed]&]newcomb = DeleteCases[lspeed, Alternatives@@outliers];データの大部分について  検定を行うと,ニューコムの光速度の測定値は実際の値よりもかなり低いことが分かる:
Mean[newcomb]//NTTest[newcomb, 33.02, "TestDataTable"]2つの実験的なキャベツの栽培品種それぞれから30個のサンプルについてビタミンCの量と全体の重さを記録した:
ExampleData[{"Statistics", "Cabbages"}, "ColumnDescriptions"]cabbageData = ExampleData[{"Statistics", "Cabbages"}];cultivar = cabbageData[[All, 1]];w39 = Pick[cabbageData[[All, 3]], cultivar, "c39"];
w52 = Pick[cabbageData[[All, 3]], cultivar, "c52"];
c39 = Pick[cabbageData[[All, 4]], cultivar, "c39"];
c52 = Pick[cabbageData[[All, 4]], cultivar, "c52"];{SmoothHistogram[{w39, w52}, PlotLabel -> "Head Weight"], SmoothHistogram[{c39, c52}, PlotLabel -> "Vitamin C", PlotLegends -> {"c39", "c52"}]}TTest[{c52, c39}, 0, "TestDataTable"]重さのデータはc52については正規分布に従わないので,MannWhitneyTestを使って軽いキャベツの方がずっと多くのビタミンCを含むことを示す:
DistributionFitTest[w52]MannWhitneyTest[{w52, w39}, 0, "TestDataTable"]アヤメの花の3つの種のそれぞれから50のサンプルが集められた.サンプルは,アヤメの萼片と花弁の長さと幅の測定値からなる.virginica および versicolor の種を区別することは難しい:
iris = ExampleData[{"Statistics", "FisherIris"}];species = iris[[All, -1]];versicolorData = Pick[iris[[All, 1 ;; -2]], species, "versicolor"];
virginicaData = Pick[iris[[All, 1 ;; -2]], species, "virginica"];Hotelling  検定は,2つの似た種について測定値の違いを示す:
TTest[{versicolorData, virginicaData}, 0, "TestDataTable"]データを可視化すると,最も大きい違いは花弁の大きさであることが分かる:
clmnDescr = ExampleData[{"Statistics", "FisherIris"}, "ColumnDescriptions"][[1 ;; -2]];
lgnd = Placed[LineLegend[{RGBColor[0.368417, 0.506779, 0.709798], RGBColor[0.880722, 0.611041, 0.142051]}, {"versicolor", "virginica"}, LegendLayout -> "Row"], Bottom];Legended[Table[SmoothHistogram[{versicolorData[[All, i]], virginicaData[[All, i]]}, PlotLabel -> clmnDescr[[i]]], {i, Length[clmnDescr]}], lgnd]特性と関係 (11)
一変量データについては, において検定統計はStudentTDistributionに従う:
data = RandomVariate[NormalDistribution[], {1000, 15}];T = Table[TTest[i, Automatic, "TestStatistic", VerifyTestAssumptions -> None], {i, data}];DistributionFitTest[T, StudentTDistribution[14]]多変量データについては, において検定統計はHotellingTSquareDistributionに従う:
data = RandomVariate[BinormalDistribution[.5], {1000, 25}];T = Table[TTest[i, Automatic, "TestStatistic", VerifyTestAssumptions -> None], {i, data}];DistributionFitTest[T, HotellingTSquareDistribution[2, 23]]𝒹1 = RandomVariate[NormalDistribution[0, 1], 100];
𝒹2 = RandomVariate[NormalDistribution[0, 1], 95];
𝒹3 = RandomVariate[NormalDistribution[0, 5], 100];L[x_] := Length[x];v[x_] := Variance[x]TTest[𝒹1, 0, "DegreesOfFreedom"]L[𝒹1] - 1TTest[{𝒹1, 𝒹2}, 0, "DegreesOfFreedom"]L[𝒹1] + L[𝒹2] - 2等しくない分散を持つ2つのサンプル(サタスウェイト(Satterthwaite)近似):
TTest[{𝒹1, 𝒹3}, 0, "DegreesOfFreedom"](((v[𝒹1]/L[𝒹1]) + (v[𝒹3]/L[𝒹3]))^2/((v[𝒹1]/L[𝒹1]))^2 / (L[𝒹1] - 1) + ((v[𝒹3]/L[𝒹3]))^2 / (L[𝒹3] - 1))使用される自由度のタイプはVerifyTestAssumptionsを使って制御できる:
𝒹1 = RandomVariate[NormalDistribution[0, 1], 95];
𝒹2 = RandomVariate[NormalDistribution[0, 5], 100];TTest[{𝒹1, 𝒹2}, 0, "DegreesOfFreedom", VerifyTestAssumptions -> {"EqualVariance" -> True, "Normality"}]Satterthwaite近似を使うために明示的に不等分散を仮定する:
TTest[{𝒹1, 𝒹2}, 0, "DegreesOfFreedom", VerifyTestAssumptions -> {"EqualVariance" -> False, "Normality"}]多変量データについては,Hotellingの  統計の計算に平方マハラノビス(Mahalanobis)距離が使われる:
data = RandomVariate[MultinormalDistribution[{1, 2, 3}, IdentityMatrix[3]], 100];MahalanobisDistanceSquared[data_, mu_] := With[{inv = Inverse@Covariance[data], m = Mean[data]}, (m - mu).inv.(m - mu)]Subscript[μ, 0] = {1, 2, 3};T2 = Length[data] * MahalanobisDistanceSquared[data, Subscript[μ, 0]] においては,検定統計はHotellingTSquareDistribution[p,n-1]に従う:
pvalue = SurvivalFunction[HotellingTSquareDistribution[3, 99], T2]TTest[data, {1, 2, 3}, "TestDataTable"]母分散が既知である場合には,より強力なZTestを使うことができる:
σ = .25;data = RandomVariate[NormalDistribution[2.5, Sqrt[σ]], {1000, 15}];T = TTest[#, 2, VerifyTestAssumptions -> None]& /@ data;Z = ZTest[#, σ, 2, VerifyTestAssumptions -> None]& /@ data;α = 0.05;
Probability[x < α, xT]//NProbability[x < α, xZ]//NTTestは正規性からの少しの偏差に対して強固である:
data = BlockRandom[SeedRandom[1];RandomVariate[𝒹 = StudentTDistribution[5], {1000, 35}]];Plot[{PDF[𝒹, x], PDF[NormalDistribution[], x]}, {x, -4, 4}, PlotLegends -> {"𝒹", NormalDistribution}]pvals = TTest[#, VerifyTestAssumptions -> None]& /@ data;
DistributionFitTest[pvals, UniformDistribution[]]正規性からの大きい偏差には,中央値に基づく検定を使う必要がある:
data = BlockRandom[SeedRandom[1];RandomVariate[𝒹 = CauchyDistribution[0, 1], {1000, 35}]];Plot[{PDF[𝒹, x], PDF[NormalDistribution[], x]}, {x, -4, 4}, PlotLegends -> {"𝒹", NormalDistribution}]tpvals = TTest[#, VerifyTestAssumptions -> None]& /@ data;srpvals = SignedRankTest /@ data//Quiet; 値は,SignedRankTestについては通常通りに解釈することができるが,TTestについてはできない:
DistributionFitTest[tpvals, UniformDistribution[]]DistributionFitTest[srpvals, UniformDistribution[]]正規性のないデータの2つのサンプルの検定にはMannWhitneyTestを使う:
data1 = RandomVariate[LaplaceDistribution[0, 1], {1000, 35}];
data2 = RandomVariate[LaplaceDistribution[.5, 1], {1000, 25}];t = MapThread[TTest[{#1, #2}, VerifyTestAssumptions -> None]&, {data1, data2}];mw = MapThread[MannWhitneyTest[{#1, #2}]&, {data1, data2}];正規性のないデータにはMannWhitneyTestの方がTTestよりも強力であることがある:
Probability[x ≤ .05, xt]//NProbability[x ≤ 0.05, xmw]//NTTestは,入力がTimeSeriesのときにのみ値に使うことができる:
ts = TemporalData[TimeSeries, {{{1.224578634529677, 0.47929635789978015, 0.6572781300178168,
    0.21496048742669355, 0.7299608014554928, -0.2495111111278263, -1.3286551762002712,
    0.552725018274874, 0.19272112205837066, 1.1809144012420882, -1.1671 ... 40938613662046, 1.052394590214582, 0.9345044123980388, 0.38537803109557855,
    -0.48660931166089394, -0.71203560340161}}, {{0, 100, 1}}, 1, {"Continuous", 1},
{"Discrete", 1}, 1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False, 10.1];TTest[ts]TTest[ts["Values"]]TTestは,入力がTemporalDataのときはすべての値に使うことができる:
td = TemporalData[Automatic, {{{-0.25275046867718637, -0.7175779198306353, -1.9370139837317764,
    0.006665621735740701, -0.3730807122324292, 0.6740106823161018, 0.8562214990564344,
    0.955785083955732, 1.7020898014886303, 1.8523009430646802, 0.244 ... 3951759101545, -1.1611722313627828, 1.1602446901533021,
    1.1052173095128992, 1.1089143920161917, -0.13837156328402}}, {{0, 100, 1}}, 2,
  {"Continuous", 2}, {"Discrete", 1}, 1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False,
10.1];TTest[td]data = td["ValueList"]//Flatten;
TTest[data]{data1, data2} = td["ValueList"];TTest[{data1, data2}]考えられる問題 (2)
TTestは,データが正規分布に従うと仮定する:
data = RandomVariate[ParetoDistribution[1, 2], 100];TTest[data]
SignTest[data]data = BlockRandom[SeedRandom[3];RandomVariate[SuzukiDistribution[0.3, 38], {15, 2}]];Quiet[TTest[data], {TTest::nortst}]
おもしろい例題 (1)

data = RandomVariate[NormalDistribution[], {2500, 100}];T1 = TTest[#, 0, "TestStatistic", VerifyTestAssumptions -> None]& /@ data;T2 = TTest[#, 1, "TestStatistic", VerifyTestAssumptions -> None]& /@ data;SmoothHistogram[{T1, T2}, Filling -> Axis, PlotLegends -> {"SubscriptBox[H, 0]は真", "SubscriptBox[H, 0]は偽"}, PlotStyle -> Thick]テキスト
Wolfram Research (2010), TTest, Wolfram言語関数, https://reference.wolfram.com/language/ref/TTest.html.
CMS
Wolfram Language. 2010. "TTest." Wolfram Language & System Documentation Center. Wolfram Research. https://reference.wolfram.com/language/ref/TTest.html.
APA
Wolfram Language. (2010). TTest. Wolfram Language & System Documentation Center. Retrieved from https://reference.wolfram.com/language/ref/TTest.html