非约束最优化:局部极小化方法
介绍

Wolfram 语言中的 FindMinimum 函数有五个基本不同的方式来选择该模型,由方法选项控制. FindMaximum 和 FindFit 也同样使用这些方法.
| "Newton" | 使用精确Hessian或者当符号化的导数不能计算的时候使用有限差分近似 |
| "QuasiNewton" | 使用 Hessian 的拟牛顿BFGS来近似,它是通过基于过去步骤的不断更新建立起来的 |
| "LevenbergMarquardt" | 最小二乘问题的高斯-牛顿方法; 其Hessian由  近似,其中  是残差函数的雅克比 |
| "ConjugateGradient" | 求解线性系统的共轭梯度法的非线性版本; 一个模型 Hessian 从来没有明确形成 |
| "PrincipalAxis" | 通过保持从过去的步骤得到的数值来工作,不使用任何导数,甚至不使用梯度; 它需要在每个变量有两个起始条件 |
FindMinimum 的基本方法选择.
当设置 Method->Automatic 时,Wolfram 语言使用 拟牛顿 方法,除非我们要求解的问题在结构上是一个平方和的形式,在这种情况下,则使用 高斯-牛顿法 方法的 Levenberg-Marquard 变型. 当每个变量都被给予两个起始条件时,则使用 主轴法 方法.
牛顿法
Wolfram 语言所提供的一个明显的优势是它可以符号化地计算导数. 这意味着,当您指定 Method->"Newton" 并且函数明确可微时,符号化求导数计算就会自动执行. 另一方面,如果函数的形式不是明确可微的话,Wolfram 语言将使用有限差分近似计算 Hessian,并使用结构信息来最小化所需计算的次数. 或者,您可以指定一个 Wolfram 语言表达式,用以对 Hessian 的变量赋予数值值.
<<Optimization`UnconstrainedProblems`FindMinimum[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], {{x, 1}, {y, 1}}, Method -> "Newton"]f[x_ ? NumberQ, y_ ? NumberQ] := Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2]我们无法找到该函数的符号式导数,因为该函数被定义为只对其变量的数值值取值.
FindMinimumPlot[f[x, y], {{x, 1}, {y, 1}}, Method -> "Newton"]
当梯度和 Hessian 都使用有限差分计算的时候,Hessian 的误差可能非常大,因而使用不同的方法可能更好. 在里,FindMinimum 很准确地找到极小值,但是因导数信息不准确而不能确保. 此外,函数和梯度计算的次数远大于在自动计算符号式导数的例子中的次数,因为对梯度和 Hessian 求近似,需要额外的计算.
如果有可能给出梯度 (或者函数的梯度可以自动计算得到的话),这种方法通常会表现得更好. 您可以通过 Gradient 选项提供梯度,它有几种方式来指定导数.
g[x_ ? NumberQ, y_ ? NumberQ] = Map[D[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], #]&, {x, y}]FindMinimum[f[x, y], {{x, 1}, {y, 1}}, Gradient -> g[x, y], Method -> "Newton"]如果您能够提供一个产生 Hessian 的程序,您也可以提供这个. 因为该Hessian只用于牛顿法,所以它作为 "Newton" 的一个方法选项被提供.
h[x_ ? NumberQ, y_ ? NumberQ] = Outer[D[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], ##]&, {x, y}, {x, y}]FindMinimum[f[x, y], {{x, 1}, {y, 1}}, Gradient -> g[x, y], Method -> {"Newton", "Hessian" -> h[x, y]}]原则上,牛顿方法要么使用通过对符号式导数求值而计算的 Hessian,要么使用通过有限差分来计算得到的 Hessian. 然而,这种计算方法的收敛决定于我们的函数是凸函数,此时 Hessian 总是正定的. 我们经常可以见到搜索过程从违反这一条件的位置起始,所以算法必须考虑到这种可能性.
FindMinimumPlot[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], {{x, 1.2}, {y, .5}}, Method -> "Newton"]当足够接近一个局部极大值的时候,Hessian 实际上是负定的.
Eigenvalues[h[1.2, .5]]在 Hessian 不是正定的情况,如果您只是应用牛顿步计算公式,就有可能得到一个不会导致函数值减少的方向.
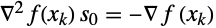
LinearSolve[h[1.2, .5], -g[1.2, .5]].g[1.2, .5]对于线搜索方法来说,利用正定的二次模型  计算方向是至关重要的,因为由此得到的搜索过程和收敛结果依赖于一个有足够下降度的方向. 参见 "线搜索方法". Wolfram 语言通过元素足够大的对角矩阵
 修正 Hessian,以使得
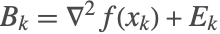 是正定的. 这种方法有时被称为修正牛顿方法. 对于
 的修正,无论是对密集的还是稀疏的 Hessian,差不多都是在按 [GMW81] 中所描述的 Cholesky 分解的计算过程中完成. 而且只有在
 不是正定的情况下才做这样的修正. 如果您想独立地使用这种分解方法的话,它可以通过 LinearSolve 访问.
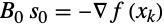

LinearSolve[h[1.2, .5], -g[1.2, .5], Method -> {"Cholesky", "Modification" -> "Minimal"}]%.g[1.2, .5]除了(修正的)牛顿法的稳健性,另一个重要方面是它的收敛速度. 一旦搜索足够接近一个局部极小值,收敛速度就可以说是  二次的,这意味着如果
 是局部极小值点,那么对于某常数

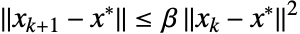
在机器精度上,这并不总是有显著的差别,因为通常绝大部分步骤花在接近局部极小值上. 但是,如果您想要一个极高精度的根,牛顿方法通常因其快速收敛性而成为最好的选择.
First[Timing[Block[{e = 0, s = 0}, {{min, minpoint}, {points}} = Reap[FindMinimum[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], {{x, 1.}, {y, 1.}}, Method -> "Newton", WorkingPrecision -> 100000, StepMonitor :> (s++;Sow[{x, y}]), EvaluationMonitor :> e++]];Print[s, " steps and ", e, " evaluations"]]]]
当使用选项 WorkingPrecision->prec 时,AccuracyGoal 和 PrecisionGoal 的默认值是 prec/2. 因此,这个例子应该找到至少精确到 50000 位数的极小值.
exact = {x, y} /. Last[Solve[{x ^ 2 + y ^ 2 == 3 Pi / 2, x ^ 2 - 3 y == -Pi}, {x, y}]] N[Map[Norm[exact - #]&, points]]这里,我们需要比步骤数目更多的函数计算次数,这是因为 Wolfram 语言自适应地把精度从初始值的精度增加到所要求的最大 WorkingPrecision. 精确度序列的选择,是要在假定点收敛于极小值的情况下,使得在最昂贵的最后精度上做尽量少的计算. 有时候,当 Wolfram 语言改变精度时,我们有必要在更高的精度上重新计算函数.
TableForm[Transpose[{Map[Precision, points], N[Map[Norm[exact - #]&, points]]}]]请注意,通常精度基本上是误差尺度  的两倍. 对于牛顿法,这是恰当的,因为当我们计算步骤时,根据二次收敛,误差尺度实际上将翻倍.
FindMinimum 总是起始于您所提供的初始值的精度. 因此,如果您不想让它使用自适应精度控制,您可以选择精确的或者至少有最大 WorkingPrecision 的数值作为初始值.
First[Timing[Block[{e = 0, s = 0}, {{min, minpoint}, {points}} = Reap[FindMinimum[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], {{x, 1}, {y, 1}}, Method -> "Newton", WorkingPrecision -> 100000, StepMonitor :> (s++;Sow[{x, y}]), EvaluationMonitor :> e++]];Print[s, " steps and ", e, " evaluations"]]]]
虽然这可能使用较少的函数计算,但它们都是在最高精度上进行的,因此通常情况下,自适应精度节省了很多时间. 例如,前面没有使用自适应精度的命令比起从机器精度开始计算花了超过 50 倍的时间.
在牛顿方法下,线搜索方法和信赖域方法的步控制都得以实现. 默认值是线搜索,前面的例子中使用的都是这个方法. 但是,其中任何一个例子也都可以采用信赖域方法完成. 该方法通常每步都需要更多的数值线性代数计算,但是由于这些步骤被更好地控制,所以它可能在较少的迭代次数里达到收敛.
p = GetFindMinimumProblem[Rosenbrock]FindMinimumPlot[p, Method -> {"Newton", "StepControl" -> "TrustRegion"}]FindMinimumPlot[p, Method -> "Newton"]从这两个图示的比较当中,您可以看到由于搜索沿着谷的方向进行,因而信赖域方法更好地控制了搜索步骤,进而用较少的函数计算达到收敛.
选项名
|
默认值
| |
| "Hessian" | Automatic | 用于计算Hessian矩阵的表达式 |
| "StepControl" | "LineSearch" | 如何控制步骤; 选项包括 "LineSearch","TrustRegion",或者 None |
Method->"Newton" 的方法选项.
拟牛顿法
我们有许多不同的拟牛顿方法. 在所有这些方法中,基本思想都是基于如下二次模型中的矩阵 
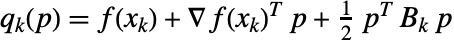
这里基于从该函数建立的 Hessian 矩阵的近似,以及从之前采取的一些或全部步骤得到的导数值的近似
<<Optimization`UnconstrainedProblems`FindMinimumPlot[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], {{x, 1}, {y, 1}}]关于这个例子中采用的路径,首先要注意的是它沿错误的方向起始. 选择这个方向,是因为在所有方法的第一步都是沿着梯度的方向,因此它采取了最速下降的方向. 然而,在随后的步骤里,它结合了已采取步骤函数值及梯度值的信息,来建立一个 Hessian 的近似模型.
Wolfram 语言所采用的方法是 Broyden-Fletcher-Goldfarb-Shanno (BGFS) 更新,而对于大型系统,则使用有限内存的 BFGS (L-BFGS) 方法. 对后者,模型  没有被明确地存储,而是通过从过去的步骤存储的梯度和步骤方向来计算
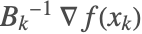 .
在 BFGS 方法的执行中,并不是在每个步骤形成模型 Hessian  ,而是计算Cholesky 因子
 ,使得
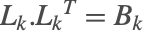 ,因此对于一个具有
 个变量的问题,只需要
 操作来求解系统
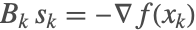 [DS96].
对于大型稀疏问题,BFGS 方法可能会产生问题,因为一般而言,Cholesky 因子(或者 Hessian 近似  或者它的逆矩阵) 是密集的,因此
 的内存和操作要求与可以利用稀疏优点的算法相比,变得令人难以承受. L-BFGS 算法[NW99] 基于过去
 步存储的信息建立一个 Hessian 矩阵的逆矩阵的近似. 该 Hessian 近似可能不是完整的,但是内存和操作的次数对于一个具有
 个变量的问题,可以限制在
 . 在 Wolfram 语言中,对于超过 250 个变量的问题,该算法自动切换至 L-BFGS. 您可以通过方法选项 "StepMemory"->m 对此进行控制. 对于
 ,我们将总是使用完全 BFGS 方法. 选择合适的
 值是对于收敛速度和每一步所做的工作量的折衷. 对于
 ,您有可能最好使用 "共轭梯度算法".

FindMinimumPlot[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], {{x, 1}, {y, 1}}, "SolutionData", Method -> {"QuasiNewton", "StepMemory" -> 5}]拟牛顿方法在 Wolfram 语言中被选为默认值,因为它们通常是相当快的,并且不需要计算 Hessian 矩阵,我们知道Hessian 矩阵无论是符号式的计算还是数值计算都可能相当昂贵. 如果用一个足够好的线搜索,它们可以超线性地收敛 [NW99] 到一个 Hessian 是正定的局部极小值. 这意味着
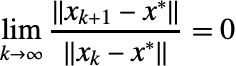
或者,换句话说,步长越变越小. 然而,对于很高的精确度,这并不能与牛顿方法的  -二次收敛速度相比较.
First[Timing[Block[{e = 0, s = 0}, {{min, minpoint}, {points}} = Reap[FindMinimum[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], {{x, 1.}, {y, 1.}}, Method -> "QuasiNewton", WorkingPrecision -> 10000, StepMonitor :> (s++;Sow[{x, y}]), EvaluationMonitor :> e++]];Print[s, " steps and ", e, " evaluations"]]]]
由于具有二次收敛速度,牛顿法能够使用更少的步骤数目找到10倍多的位数. 然而,拟牛顿法的收敛速度仍然是超线性的,因为误差的比率明显趋近于零.
exact = {x, y} /. Last[Solve[{x ^ 2 + y ^ 2  == 3  Pi / 2, x ^ 2 - 3 y == -Pi}, {x, y}]];errs = Map[Norm[N[exact - #]]&, points];
ListPlot[Log[10, Drop[errs, 1] / Drop[errs, -1]]]
选项名
|
默认值
| |
| "StepMemory" | Automatic | 在 Hessian 近似中需要“记住”有效步骤数目;可以是一个正整数或者是 Automatic |
| "StepControl" | "LineSearch" | 如何控制步骤; 可以是 "LineSearch" 或者 None |
Method->"QuasiNewton" 的方法选项.
高斯-牛顿法
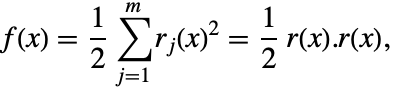
的极小化问题,往往可以利用问题的这一特殊结构. 通过计算残差函数  ,和它的导数,以及雅克比
 ,我们可以节约时间和精力. 高斯-牛顿法就是用来解决这一问题的巧妙方法. 高斯-牛顿法没有使用二次模型的整个二阶 Hessian 矩阵,而是在 (1) 中使用
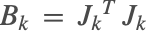 ,这样就使得步骤
 可以用公式

来计算,其中 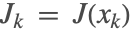 ,等等. 请注意,这是对完整 Hessian,即
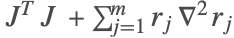 的近似. 在残差为零的情况下,即
 是极小值时,或者当
 在极小值点附近线性变化时,对 Hessian 的近似是相当不错的,并且牛顿法的二次收敛性也通常得到遵守.
平方和形式的目标函数是很常见的,而且实际上,这正是使用 FindFit 时,选用 NormFunction 选项的默认值的情况下,目标函数的形式. 考查高斯-牛顿法的方法之一,是以最小二乘问题的形式. 求解高斯-牛顿步骤与求解线性最小二乘问题相同,所以应用一个高斯-牛顿方法实际上是对一个对非线性函数采取一系列的线性最小二乘拟合. 从这一观点来看,说这种方法尤其适用于 FindFit 所进行的一类非线性拟合就可以理解了.
<<Optimization`UnconstrainedProblems`p = GetFindMinimumProblem[Rosenbrock]当 Wolfram 语言遇到一个明确表示为平方和形式的问题,比如 Rosenbrock 的例子,或者是一个向量和自身点乘形式的函数,高斯-牛顿法就会自动被使用.
FindMinimumPlot[p, Method -> "GaussNewton"]如果您比较一下对相同的例子使用牛顿法,您可以看到我们是用了较少的步骤数和求值次数完成的,这是因为高斯-牛顿法利用了问题的特殊结构的优点. 在极小值附近的收敛速度就和牛顿法的一样好,因为在极小值的残差为零.
Levenberg–Marquardt 方法是使用信赖域步骤控制法的高斯-牛顿方法(虽然这是在信赖域的普遍概念形成之前提出的). 您可以使用 FindMinimum 选项 Method->"LevenbergMarquardt" 或者等效的 Method->"GaussNewton" 具体要求使用该方法.
有时候把函数明确表达为平方和的形式或者是向量和自身点乘的形式是有些别扭的. 在这种情况下,我们有可能可以使用 "Residual" 方法选项直接具体指定残差. 同样,您可以通过 "Jacobian" 方法选项具体指定残差的导数. 请注意,当通过 "Residual" 方法选项具体指定残差时,它不会就是否与FindMinimum 的第一个参数一致进行检查. 返回的值将取决于通过选项给定的值.
FindMinimum[(1/2)((1 - Subscript[X, 1])^2 + 100 (-Subsuperscript[X, 1, 2] + Subscript[X, 2])^2), {{Subscript[X, 1], -1.2}, {Subscript[X, 2], 1.}}, Method -> {"LevenbergMarquardt", "Residual" -> {1 - Subscript[X, 1], 10(-Subsuperscript[X, 1, 2] + Subscript[X, 2])}}]
选项名
|
默认值
| |
| "Residual" | Automatic | 允许您直接指定残差  使得 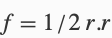 |
| "EvaluationMonitor" | Automatic | 每次对残差求值时一同求值的表达式 |
| "Jacobian" | Automatic | 允许您指定残差的(矩阵)导数 |
| "StepControl" | "TrustRegion" | 必须是 "TrustRegion",但是允许您通过方法选项改变控制参数 |
Method->"LevenbergMarquardt" 的方法选项.
另一种在 Wolfram 语言中建立平方和形式的问题的自然方式是使用 FindFit,它是计算数据的非线性拟合的. 下面是一个简单的例子.
fm[a_, b_, c_, x_] := a If[x > 0, Cos[b x], Exp[c x]]Block[{ϵ = 0.1, a = 1.2, b = 3.4, c = 0.98}, data = Table[{x, fm[a, b, c, x] + ϵ RandomReal[ {-.5, .5}]}, {x, -5, 5, .1}]];fit = FindFit[data, fm[a, b, c, x], {{a, 1}, {b, 3}, {c, 1}}, x]Show[{ListPlot[data], Plot[fm[a, b, c, x] /. fit, {x, -5, 5}, PlotStyle -> RGBColor[0, 1, 0]]}]在这个例子中,FindFit 在内部建立一个残差函数和雅克比,进而为高斯-牛顿法所用以寻找平方和的最小值,或者是非线性最小二乘拟合. 当然,FindFit 可以和其他方法一起使用,但由于可以构造能够迅速求值的残差函数,它常常快于其他方法.
非线性共轭梯度法
非线性共轭梯度法的基础是有效地运用线性共轭梯度法,其中残差被梯度取代. 因为从未产生明确的二次函数模型,所以它总是和线搜索方法结合起来使用.
第一种非线性共轭梯度法由 Fletcher 和 Reeves 提出的. 给定一个步骤方向  ,然后使用线搜索方法找到
 使得
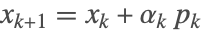 . 然后计算
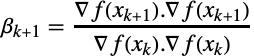
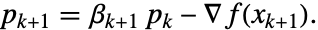
至关重要的一点是用以选择  的线搜索满足强 Wolfe 条件; 这是确保方向
 是下降方向所必要的 [NW99]].
另一种通常(但并不总是)在实践中表现更好的方法是由Polak和Ribiere提出的,其中方程(2)由如下式子替代
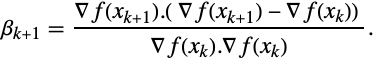
在方程式(3)中, 有可能变成负的,在这种情况下,Wolfram 语言使用由
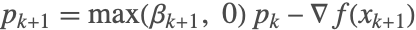 修改的算法. 在 Wolfram 语言中,默认的共轭梯度法是Polak-Ribere方法,但是也可以通过方法选项
Method->{"ConjugateGradient",Method->"FletcherReeves"}
共轭梯度法的优势是,它们对于大规模问题使用较少的内存而且不需要数值线性代数处理,所以每个步骤都相当快. 缺点是,它们通常收敛速度显著慢于牛顿或者拟牛顿方法. 另外,步长的尺度通常也掌握得很差,因此线搜索算法每次可能需要更多的迭代,以找到一个可以接受的步骤.
<<Optimization`UnconstrainedProblems`FindMinimumPlot[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], {{x, 1}, {y, 1}}, "SolutionData", Method -> "ConjugateGradient"]非线性共轭梯度法带来的一个问题是何时重新启动它们. 当我们的搜索过程中,对函数的局部二次近似的性质也可能显著改变. 方法的局部收敛性取决于线性共轭梯度法的局部收敛性,对后者二次函数是不变的. 在一个具有 n 个变量的恒值二次函数和一个精确线搜索的情况下,线性算法将在 n 或更少迭代次数里达到收敛. 通过频繁的重新启动(采取 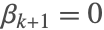 的最速下降步骤),有可能消除前面点的信息,而这些点的信息可能和目前搜索点的局部二次模型不相关. 如果您仔细查看这个例子,您可以看到方法重新启动的位置以及采取最速下降步骤的位置. 一种选择是在每 k 次迭代后,简单地重新启动,其中 k<=n. 对此您可以使用方法选项"RestartIterations"->k 具体指定. 另一个方法是根据下列测试,连续梯度不足够正交时,重新启动
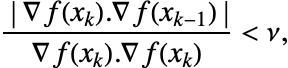
其中阈值 ν 在 0 和 1之间,可以用方法选项 "RestartThreshold"->ν 具体指定.
选项名
|
默认值
| |
| "Method" | "PolakRibiere" | 非线性共轭梯度法可以是 "PolakRibiere" 或者是 "FletcherReeves" |
| "RestartThreshold" | 1/10 | 梯度正交性的阈值 ν,低于该值的时候将重新启动 |
| "RestartIterations" | ∞ | 多少个迭代次数后将重新启动 |
| "StepControl" | "LineSearch" | 必须是 "LineSearch",但您可以使用这个来指定线搜索方法 |
Method->"ConjugateGradient" 的方法选项.
应当指出的是,在 Wolfram 语言 4 版本中 FindMinimum 的默认方法是结合了近似精确线搜索法的共轭梯度法. 由于历史的原因这一特点被保存下来,并且可以利用 FindMinimum 选项 Method->"Gradient" 访问. 通常,这将比更新的Method->"ConjugateGradient" 使用更多的函数和梯度求值次数,而后者本身所用的求值次数已远远超过 Wolfram 语言目前默认时所使用的方法.
主轴法
高斯-牛顿和共轭梯度方法使用导数信息. 当 Wolfram 语言不能计算符号化表示的导数时,则使用有限差分法. 使用有限差分计算导数信息在某些情况下将产生显著的成本增加,而且也肯定会影响导数的可靠性,最终可以对达到的极小值的近似程度产生影响. 对于不能获得符号化表示的导数的函数,另一种方法是使用一个无导数算法,只使用函数求值来建立近似模型.
Wolfram 语言使用 Brent 的主轴法 [Br02] 作为无导数算法. 对于一个具有  个变量的问题,取一个由搜索方向
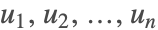 构成的集合和一个点
 . 让
 作为沿着方向
 从
 最小化
 的点(即从
 进行一个线搜索),然后用
 代替
 . 结束时,用
 代替
 . 理想的情况是,新的
 应该是线性无关的,所以可以进行一轮新的迭代,但是在实践中,它们不是线性无关的. Brent 算法包含了在矩阵
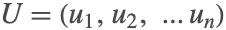 上使用奇异值分解(SVD),以将它们调整到局部二次模型的主方向上.(本来也可以使用特征分解,但是 Brent 证明 SVD 更有效.)利用获得的
 的新集合,我们可以进行另一轮迭代.
对于这种方法来说,每个变量需要两个不同的初始条件,因为这些是用来定义向量  的大小的. 事实上,只要您在每个变量上指定两个初始条件,FindMinimum、FindMaximum 和 FindFit 将默认地使用主轴算法.
<<Optimization`UnconstrainedProblems`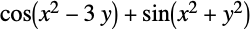
FindMinimumPlot[Cos[x ^ 2 - 3 y] + Sin[x ^ 2 + y ^ 2], {{x, 1.4, 1.5}, {y, 1, 1.1}}, "SolutionData", Method -> "PrincipalAxis"]搜索算法的基本信息可以从图示中很清楚地看到,因为无导数的线性搜索算法需要大量的函数求值. 首先,在  方向进行一个线搜索,然后从该点在
 方向进行一个线搜索,从而确定步骤的方向. 一旦采取了步骤,我们就根据局部二次近似的主方向对向量
 进行适当的调整,然后下一步进行同样的计算.
该算法就收敛速度而言是有效的;在步骤方面它具有二次收敛速度. 但是,就对函数求值次数,这是很昂贵的,因为需要无导数的线搜索方法. 请注意,由于所给的线搜索的方向(特别是在开始的时候)不一定是下降方向,线搜索必须能够在两个方向进行搜索. 对于有许多变量的问题,在所有方向的单独线搜索变得非常昂贵,因此这种方法通常更适合没有太多变量的问题.