

SpearmanRankTest
SpearmanRankTest[v1,v2]
ベクトル v1と v2が独立かどうかの検定を行う.
SpearmanRankTest[m1,m2]
行列 m1と m2が独立かどうかの検定を行う.
SpearmanRankTest[…,"property"]
"property"の値を返す.
詳細とオプション
- SpearmanRankTestは,v1と v2に対して,ベクトルが独立であるという帰無仮説
 と,そうではないという対立仮説
 で仮説検定を行う.
- デフォルトで,確率値つまり
 値が返される.
- 小さい
 値は
 が真である可能性が低いことを示す.
- 引数 v1と v2 は任意の同じ長さの実ベクトルあるいは実行列でよい.
- SpearmanRankTestはSpearmanRho[v1,v2]で計算されたSpearmanの順位相関
 に基づいている.
- 行列の検定の際は,検定統計は内部の標準的な空間順位に基づいておりChiSquareDistribution[r*s]に漸近的に従う.ただし,r と s はそれぞれ m1と m2の大きさである.検定はアフィン変換の下で不変である.
- SpearmanRankTest[v1,v2,"HypothesisTestData"]はHypothesisTestDataオブジェクト htd を返す.このオブジェクトは,htd["property"] の形を使った追加的な検定結果と特性の抽出に使える.
- SpearmanRankTest[v1,v2,"property"]を使って"property"の値を直接与えることができる.
- 検定結果のレポートに関連する特性
-
"DegreesOfFreedom" 検定の自由度 "PValue" 検定の  値
"PValueTable"  値を含むフォーマットされた表
"ShortTestConclusion" 検定結果の短い記述 "TestConclusion" 検定結果の記述 "TestData" 検定統計量と  値を含むリスト
"TestDataTable"  値と検定統計量のフォーマットされた表
"TestStatistic" 検定統計量 "TestStatisticTable" 検定統計量を含むフォーマットされた表 - 使用可能なオプション
-
AlternativeHypothesis "Unequal" 対立仮説のための不等式 MaxIterations Automatic 多変量検定の際の最大反復回数 Method Automatic  値の計算に使用するメソッド
SignificanceLevel 0.05 診断とレポートのための切捨て - 独立性の検定については,
 のときにのみ
 が拒絶されるような切捨て
 が選ばれる."TestConclusion"特性と"ShortTestConclusion"特性に使われる
 の値はSignificanceLevelオプションで制御される.デフォルトで,
 は0.05に設定されている.
例題
すべて開く すべて閉じる例 (2)
{v1, v2} = Transpose[RandomVariate[BinormalDistribution[-.8], 100]];ListPlot[Transpose[{v1, v2}]]SpearmanRankTest[v1, v2, "TestDataTable"]BlockRandom[
SeedRandom[2];
data1 = RandomVariate[BinormalDistribution[.5], 100];
data2 = RandomVariate[BinormalDistribution[.5], 100];
]SpearmanRankTest[data1, data2, "TestDataTable"]スコープ (8)
検定 (5)
{v1, v2} = Transpose[RandomVariate[BinormalDistribution[0], 100]];{v3, v4} = Transpose[RandomVariate[BinormalDistribution[.7], 100]];
SpearmanRankTest[v1, v2]
SpearmanRankTest[v3, v4]Σ1 = {{12.8, 0.3, 3., -1.5, 5.1}, {0.3, 2.4, 0.9, -0.3, -0.8}, {3., 0.9, 6.5, 0.8, 1.3}, {-1.5, -0.3, 0.8, 1.4, 2.}, {5.1, -0.8, 1.3, 2., 11.1}};data1 = RandomVariate[MultinormalDistribution[{0, 0, 0, 0, 0}, Σ1], 100];
SpearmanRankTest[data1[[All, 1 ;; 2]], data1[[All, 3 ;; 5]]]
Σ2 = IdentityMatrix[5];data2 = RandomVariate[MultinormalDistribution[{0, 0, 0, 0, 0}, Σ2], 100];SpearmanRankTest[data2[[All, 1 ;; 2]], data2[[All, 3 ;; 5]]]繰り返し特性を抽出するためにHypothesisTestDataオブジェクトを作成する:
{v1, v2} = Transpose[RandomVariate[BinormalDistribution[0], 100]];ℋ = SpearmanRankTest[v1, v2, "HypothesisTestData"];ℋ["Properties"]HypothesisTestDataオブジェクトからいくつかの特性を抽出する:
{v1, v2} = Transpose[RandomVariate[BinormalDistribution[0], 100]];ℋ = SpearmanRankTest[v1, v2, "HypothesisTestData"];
ℋ["PValue"]ℋ["TestStatistic"]{v1, v2} = Transpose[RandomVariate[BinormalDistribution[0], 100]];ℋ = SpearmanRankTest[v1, v2, "HypothesisTestData"];
ℋ["PValue", "TestStatistic"]レポート (3)
{v1, v2} = Transpose[RandomVariate[BinormalDistribution[0], 100]];ℋ = SpearmanRankTest[v1, v2, "HypothesisTestData"];ℋ["TestDataTable"]{v1, v2} = Transpose[RandomVariate[BinormalDistribution[0], 100]];ℋ = SpearmanRankTest[v1, v2, "HypothesisTestData"];res = ℋ["TestData"]Labeled[ProgressIndicator[res[[2]]], Row[{Style["ρ: ", Bold, FontSize -> 14], res[[1]]}]]
{v1, v2} = Transpose[RandomVariate[BinormalDistribution[0], 100]];ℋ = SpearmanRankTest[v1, v2, "HypothesisTestData"];ℋ["PValueTable"]
ℋ["PValue"]ℋ["TestStatisticTable"]ℋ["TestStatistic"]オプション (9)
AlternativeHypothesis (3)
{v1, v2} = Transpose@RandomVariate[CopulaDistribution[{"Clayton", 1}, {NormalDistribution[], NormalDistribution[]}], 100];SpearmanRankTest[v1, v2, AlternativeHypothesis -> "Unequal"]SpearmanRankTest[v1, v2, AlternativeHypothesis -> Automatic]{v1, v2} = Transpose@RandomVariate[CopulaDistribution[{"Clayton", 3}, {NormalDistribution[], NormalDistribution[]}], 100];SpearmanRankTest[v1, v2, AlternativeHypothesis -> "Unequal"]SpearmanRankTest[v1, v2, AlternativeHypothesis -> "Less"]SpearmanRankTest[v1, v2, AlternativeHypothesis -> "Greater"]m1 = RandomVariate[BinormalDistribution[0], 50];
m2 = RandomVariate[BinormalDistribution[0], 50];SpearmanRankTest[m1, m2, AlternativeHypothesis -> "Less"]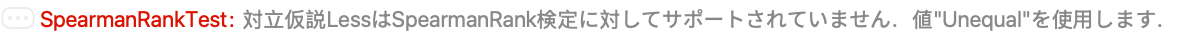
m1 = RandomVariate[BinormalDistribution[0], {250, 50}];
m2 = RandomVariate[BinormalDistribution[0], {250, 50}];t = MapThread[SpearmanRankTest[#1, #2, "TestStatistic"]&, {m1, m2}];Histogram[t]MaxIterations (1)
data1 = RandomVariate[BinormalDistribution[.5], 25];
data2 = RandomVariate[BinormalDistribution[.5], 25];
SpearmanRankTest[data1, data2, MaxIterations -> 1000]設定値を低くすると計算時間は短くなるかもしれないが,収束しなくなる可能性がある:
SpearmanRankTest[data1, data2, MaxIterations -> 5]

Method (4)
デフォルトで, 値は漸近的検定統計量分布を使って計算される:
{v1, v2} = Transpose@RandomVariate[CopulaDistribution[{"Clayton", 1}, {NormalDistribution[], NormalDistribution[]}], 100];SpearmanRankTest[v1, v2, Method -> Automatic]SpearmanRankTest[v1, v2, Method -> "Asymptotic"]
{v1, v2} = Transpose@RandomVariate[CopulaDistribution[{"Clayton", 3}, {NormalDistribution[], NormalDistribution[]}], 10];SpearmanRankTest[v1, v2, Method -> "Permutation"]{v1, v2} = Transpose@RandomVariate[CopulaDistribution[{"Clayton", 3}, {NormalDistribution[], NormalDistribution[]}], 10];SpearmanRankTest[v1, v2, Method -> {"Permutation", "MonteCarloSamples" -> 10^4}]
SpearmanRankTest[v1, v2, Method -> {"Permutation", "MonteCarloSamples" -> 10^3}]SpearmanRankTest[v1, v2, Method -> {"Permutation", "MonteCarloSamples" -> Automatic}]{v1, v2} = Transpose@RandomVariate[CopulaDistribution[{"Clayton", 3}, {NormalDistribution[], NormalDistribution[]}], 10];SpearmanRankTest[v1, v2, Method -> {"Permutation", "RandomSeed" -> 0}]SpearmanRankTest[v1, v2, Method -> {"Permutation", "RandomSeed" -> 9}]SignificanceLevel (1)
有意水準は"TestConclusion"と"ShortTestConclusion"に使われる:
BlockRandom[SeedRandom[3];{v1, v2} = Transpose@RandomVariate[CopulaDistribution[{"Clayton", 3}, {NormalDistribution[], NormalDistribution[]}], 100];];ℋ1 = SpearmanRankTest[v1, v2, "HypothesisTestData", SignificanceLevel -> .05];ℋ2 = SpearmanRankTest[v1, v2, "HypothesisTestData", SignificanceLevel -> .000005];ℋ1["TestConclusion"]//TraditionalFormℋ2["TestConclusion"]//TraditionalFormℋ1["ShortTestConclusion"]ℋ2["ShortTestConclusion"]特性と関係 (9)
ベクトル間の比較の際は,検定統計がSpearmanRhoとして計算される:
v1 = RandomVariate[NormalDistribution[], 100];
v2 = RandomVariate[NormalDistribution[], 100];SpearmanRankTest[v1, v2, "TestStatistic"]SpearmanRho[v1, v2]検定統計は  の下でStudentTDistribution[n-2]に従う:
n = 100;data = RandomVariate[BinormalDistribution[0], {1000, n}];ρ = SpearmanRankTest[Sequence@@Transpose[#], "TestStatistic"]& /@ data;ρTrans = ρ Sqrt[(n - 2) / (1 - ρ^2)];QuantilePlot[ρTrans, StudentTDistribution[n - 2]]DistributionFitTest[ρTrans, StudentTDistribution[n - 2]]より大きい場合,検定統計はChiSquareDistribution[r*s]に従う:
data1 = RandomVariate[BinormalDistribution[0], {250, 50}];
data2 = RandomVariate[BinormalDistribution[0], {250, 50}];t = MapThread[SpearmanRankTest[#1, #2, "TestStatistic"]&, {data1, data2}];QuantilePlot[t, ChiSquareDistribution[2 * 2]]DistributionFitTest[t, ChiSquareDistribution[2 * 2]]行列の比較の場合は,検定統計はアフィン変換の下で不変である:
m = RandomVariate[MultinormalDistribution[{1, 2, 3, 4}, {{12.8, 0.3, 3., -1.5}, {0.3, 2.4, 0.9, -0.3}, {3., 0.9, 6.5, 0.8}, {-1.5, -0.3, 0.8, 1.4}}], 100];𝒯 = AffineTransform[{{{1, 2}, {3, 4}}, {1, 2}}];SpearmanRankTest[m[[All, 1 ;; 2]], m[[All, 3 ;; 4]], "TestDataTable"]SpearmanRankTest[𝒯[m[[All, 1 ;; 2]]], 𝒯[m[[All, 3 ;; 4]]], "TestDataTable"]CorrelationTestを使ってSpearmanの  値の特別な値の検定を行う:
v1 = RandomVariate[NormalDistribution[], 100];
v2 = RandomVariate[NormalDistribution[], 100];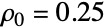
CorrelationTest[Transpose[{v1, v2}], 0.25, {"TestDataTable", "SpearmanRank"}]IndependenceTestを使って適切な独立性の検定を選ぶことができる:
v1 = RandomVariate[NormalDistribution[], 100];
v2 = RandomVariate[NormalDistribution[], 100];IndependenceTest[v1, v2, "TestDataTable"]SpearmanRankTestは使用可能な検定の一つである:
IndependenceTest[v1, v2, {"TestDataTable", "SpearmanRank"}]SpearmanRankTestは単調依存しか検出しない:
x = Sort[RandomReal[{-1, 1}, 250]];
y = Tan[x] ^ 3 + RandomReal[{-.25, .25}, 250];
z = Tan[x] ^ 4 + RandomReal[{-.25, .25}, 250];ListPlot[#, Frame -> True]& /@ {Transpose[{x, y}], Transpose[{x, z}]}SpearmanRankTest[x, y]SpearmanRankTest[x, z]HoeffdingDTestを使うと,より広い範囲の依存構造が検出ができる:
HoeffdingDTest[x, y]HoeffdingDTest[x, z]Spearmanの順位検定は,入力がTimeSeriesのときにのみ値に使うことができる:
ts1 = TemporalData[TimeSeries, {{{1.224578634529677, 0.47929635789978015, 0.6572781300178168,
    0.21496048742669355, 0.7299608014554928, -0.2495111111278263, -1.3286551762002712,
    0.552725018274874, 0.19272112205837066, 1.1809144012420882, -1.1671 ... 40938613662046, 1.052394590214582, 0.9345044123980388, 0.38537803109557855,
    -0.48660931166089394, -0.71203560340161}}, {{0, 100, 1}}, 1, {"Continuous", 1},
{"Discrete", 1}, 1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False, 10.1];ts2 = TemporalData[TimeSeries, {{{-1.2160757838495546, 0.5212591188357838, -0.0932747538180776,
-2.306367634798702, -2.5366722726947994, -0.7924813212437647, -2.65435901675047,
-1.1098678592653723, -0.7814091835518528, -1.9685555851254093, -0.0 ... 1001061264, -0.1887471329804458, -2.0547107874294928, -1.3896240275653011,
-0.5073077090484948, 0.13302942350391606}}, {{0, 100, 1}}, 1, {"Continuous", 1},
{"Discrete", 1}, 1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False, 10.1];SpearmanRankTest[ts1, ts2]SpearmanRankTest[ts1["Values"], ts2["Values"]]Spearmanの順位検定は,入力がTemporalDataのときは値全体に同時に使うことができる:
td = TemporalData[Automatic, {{{0.6327956976018951, 0.49307164456668334, -0.11865815946302549,
    -1.6346246228913748, -1.8053674367955113, -1.0171193599509663, -1.713536030590108,
    -0.2441834126183119, 1.468610531363788, 2.5403283801476966, 0.862 ... 135928877112, 0.8411464201445826, 0.36308201253335104, -0.45737292436875443,
    0.289078430933834, 0.12996366812717347}}, {{0, 100, 1}}, 4, {"Continuous", 4}, {"Discrete", 1},
1, {ValueDimensions -> 1, ResamplingMethod -> None}}, False, 10.1];SpearmanRankTest[td]
paths = td["Components"]SpearmanRankTest[paths[[2]], paths[[3]]]Evaluate[Array[data, 4]] = td["ValueList"];SpearmanRankTest[data[2], data[3]]おもしろい例題 (1)

data1 = RandomVariate[BinormalDistribution[0.], {1500, 100}];T1 = MapThread[SpearmanRankTest[#1, #2, "TestStatistic"]&, {data1[[All, All, 1]], data1[[All, All, 2]]}];data2 = RandomVariate[BinormalDistribution[0.7], {1500, 100}];T2 = MapThread[SpearmanRankTest[#1, #2, "TestStatistic"]&, {data2[[All, All, 1]], data2[[All, All, 2]]}];SmoothHistogram[{T1, T2}, Filling -> Axis, PlotLegends -> {"SubscriptBox[H, 0]は真", "SubscriptBox[H, 0]は偽"}]テキスト
Wolfram Research (2012), SpearmanRankTest, Wolfram言語関数, https://reference.wolfram.com/language/ref/SpearmanRankTest.html.
CMS
Wolfram Language. 2012. "SpearmanRankTest." Wolfram Language & System Documentation Center. Wolfram Research. https://reference.wolfram.com/language/ref/SpearmanRankTest.html.
APA
Wolfram Language. (2012). SpearmanRankTest. Wolfram Language & System Documentation Center. Retrieved from https://reference.wolfram.com/language/ref/SpearmanRankTest.html